JavaScript Rendering, Initial HTML, Hydration, Client-Side Data Loading, SSR, SSG ve Crawler Rendering İlişkisi
Bu yazıda JavaScript rendering, initial HTML, hydration, client-side data loading, SSR, SSG ve arama motoru tarayıcılarının içerik işleme süreçleri birbiriyle ilişkili şekilde teknik olarak açıklanır. React, Next.js ve benzeri frameworkleri kullanan geliştiriciler ile SEO uzmanları için, Googlebot ve benzeri crawler'ların HTML alma, JavaScript çalıştırma, render kuyruğu, içerik keşfi ve indexleme davranışları detaylı olarak ele alınır. Ayrıca performans, crawl budget, içerik görünürlüğü, metadata üretimi, dahili linkleme ve doğru mimari seçimleri konusunda uygulanabilir öneriler sunulur.
JavaScript tabanlı modern web uygulamaları kullanıcı deneyimi açısından büyük avantaj sağlar, ancak arama motorlarının bu sayfaları nasıl işlediği hâlâ çok sık yanlış anlaşılır. Özellikle React, Next.js, Nuxt, Vue ve benzeri frameworkler kullanıldığında, ekranda gördüğümüz içerik ile crawler'ın ilk aşamada gördüğü içerik aynı olmayabilir. Bu fark, indekslenebilirlikten meta verilerin algılanmasına, dahili link keşfinden performans sinyallerine kadar birçok SEO sonucunu doğrudan etkiler.
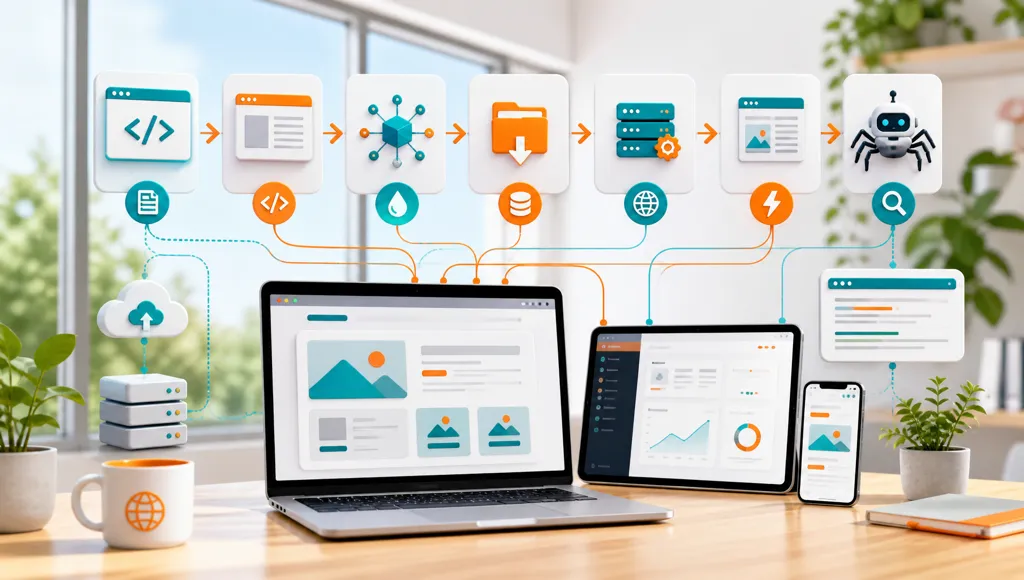
Bu nedenle JavaScript rendering, initial HTML, hydration, client-side data loading, SSR, SSG ve crawler rendering süreçlerini birbirinden bağımsız kavramlar gibi değil, tek bir teslim zincirinin parçaları olarak değerlendirmek gerekir. Bir sayfanın kullanıcıya nasıl ulaştığı ile arama motoruna nasıl ulaştığı çoğu zaman benzer görünse de teknik olarak önemli ayrımlar vardır. Konuyu doğru anlamak, hem teknik mimari kararlarını hem de SEO stratejisini daha sağlam kurmayı sağlar.
JavaScript rendering nedir ve neden tek başına yeterli bir açıklama değildir?
JavaScript rendering, sayfa içeriğinin tarayıcıda veya crawler'ın render ortamında JavaScript çalıştırılarak oluşturulması anlamına gelir. Ancak bu tanım, tek başına çok geniştir çünkü içerik tamamen istemci tarafında da üretilebilir, sunucudan kısmen hazır HTML de gelebilir veya statik üretilmiş HTML sonradan etkileşim kazanabilir. Yani rendering dediğimiz şey aslında içeriğin nerede, ne zaman ve hangi aşamada üretildiğini anlatan daha büyük bir sistemin yalnızca bir parçasıdır.
SEO açısından kritik olan nokta, arama motorunun ilk istekte ne gördüğü ve ikinci aşamada ne kadarını işleyebildiğidir. Bir sayfa kullanıcı tarayıcısında kusursuz görünse bile crawler ilk HTML içinde anlamlı içerik bulamazsa keşif ve sıralama süreçleri gecikebilir. Bu yüzden JavaScript rendering'i yalnızca "Google JavaScript çalıştırabiliyor" cümlesiyle açıklamak yetersiz kalır.
Pratikte üç ayrı görünümden söz etmek gerekir: ağ yanıtı olarak gelen initial HTML, JavaScript sonrası oluşan DOM ve kullanıcı etkileşiminden sonra zenginleşen son arayüz. Geliştiriciler çoğu zaman yalnızca son görünümü test eder. Oysa SEO uzmanı ve geliştirici birlikte ilk HTML, render edilmiş HTML ve son kullanıcı görünümü arasındaki farkı ayrıca incelemelidir.
Initial HTML: crawler'ın ilk gördüğü katman neden bu kadar önemlidir?
Initial HTML, sunucunun ilk isteğe verdiği ham HTML yanıtıdır. Tarayıcı veya crawler JavaScript dosyalarını indirmeden önce bu içeriği alır ve ilk değerlendirmesini bunun üzerinden yapar. Başlık, açıklama, canonical, hreflang, yapılandırılmış veri, ana metin, H1 ve temel dahili linkler bu aşamada varsa, keşif ve anlama süreçleri daha stabil ilerler.
Birçok JavaScript uygulamasında initial HTML çok zayıf olabilir. Örneğin yalnızca boş bir root div, birkaç script etiketi ve çok sınırlı metadata dönebilir. Kullanıcı tarafında içerik sonradan yüklense bile crawler ilk aşamada yeterli bağlam bulamazsa sayfanın amacı, konu bütünlüğü ve link yapısı eksik algılanabilir.
Bu nokta özellikle büyük içerik siteleri, kategori sayfaları, ürün listelemeleri ve şehir veya hizmet odaklı landing page'lerde önem kazanır. Çünkü bu tip sayfalarda ilk HTML içinde metinsel bağlamın bulunması, sayfanın ne hakkında olduğunu arama motoruna çok daha hızlı anlatır. Eğer içerik yalnızca API çağrısı tamamlandıktan sonra görünüyorsa, render sırasındaki gecikme indekslenebilirlik üzerinde baskı oluşturabilir.
Initial HTML aynı zamanda sosyal paylaşım botları ve bazı üçüncü parti tarayıcılar açısından da kritiktir. Her bot Google kadar gelişmiş render sürecine sahip değildir. Bu nedenle özellikle Open Graph, title, description ve ana başlık gibi unsurların mümkün olduğunca ilk HTML içinde yer alması güvenli ve sürdürülebilir bir yaklaşımdır.
Hydration nasıl çalışır ve SEO ile ilişkisi tam olarak nedir?
Hydration, sunucudan veya statik üretimden gelen HTML'in tarayıcıda JavaScript ile etkileşimli hale getirilmesidir. Basitçe söylemek gerekirse kullanıcı ilk etapta bir HTML görür, ardından framework istemci tarafında bileşen ağacını bağlar ve butonlar, formlar, filtreler, sekmeler gibi etkileşimli alanlar aktif olur. React ve Next.js mimarisinde hydration, performans ve kullanıcı deneyimi açısından merkezi bir kavramdır.
SEO tarafında sık yapılan hata, hydration ile rendering'i aynı şey sanmaktır. Oysa hydration çoğu zaman zaten görünür olan HTML'e davranış ekler. Eğer anlamlı içerik ilk HTML içinde varsa, hydration gecikse bile crawler temel içeriği görebilir. Ancak içerik hydration sonrasında ortaya çıkıyorsa, o zaman mesele yalnızca etkileşim değil, doğrudan görünürlük ve indekslenebilirlik problemine dönüşür.
Hydration mismatch gibi sorunlar da dolaylı SEO etkileri üretebilir. Sunucu tarafında oluşturulan işaretleme ile istemci tarafında üretilen çıktı tutarsızsa, kullanıcı tarafında layout kaymaları, içerik değişimleri veya hatalı render davranışları görülebilir. Bu durum Core Web Vitals, kullanıcı etkileşimi ve teknik kalite sinyalleri açısından istenmeyen sonuçlar doğurabilir.
Özellikle büyük bileşen ağaçlarında, ilk HTML içerik açısından güçlü ama hydration çok ağırsa, kullanıcı görünürde dolu bir sayfa almasına rağmen etkileşim geç açılır. Bu doğrudan indeksleme sorunu olmayabilir, ancak kullanıcı deneyimi ve dönüşüm performansı etkilenir. Dolayısıyla hydration, SEO açısından yalnızca "Google görüyor mu" sorusuyla değil, performans ve kullanılabilirlik bağlamında da değerlendirilmelidir.
Client-side data loading neden SEO açısından riskli olabilir?
Client-side data loading, sayfanın ilk HTML'i geldikten sonra JavaScript ile API çağrısı yapıp içeriği istemci tarafında doldurma yaklaşımıdır. Tek başına yanlış değildir ve birçok dashboard, üyelik alanı veya yüksek etkileşimli uygulama için son derece uygundur. Sorun, indekslenmesi beklenen ana içeriğin tamamen bu modele bağımlı hale gelmesinde ortaya çıkar.
Örneğin ürün listeleme sayfasında başlıklar, ürün kartları, açıklamalar, fiyatlar ve dahili linkler ilk HTML'de yoksa; yalnızca istemci tarafında API yanıtıyla geliyorsa crawler bu içeriği hemen göremeyebilir. Google zaman zaman JavaScript'i işleyebilir, ancak bu işleme ikinci aşamada ve kaynak planlamasına bağlı şekilde gerçekleşir. Bu da içerik keşfi, güncelleme yakalama ve hızlı indeksleme açısından gecikme yaratabilir.
Bir diğer problem, API çağrılarının crawler ortamında başarısız olabilmesidir. CORS kısıtları, kimlik doğrulama akışları, rate limit, çevresel değişken farkları veya istemci hataları nedeniyle kullanıcıda çalışan veri çağrısı crawler render ortamında her zaman aynı sonucu vermez. Geliştirici yerel testte sayfayı dolu görse bile arama motoru eksik ya da boş içerik yakalayabilir.
Client-side data loading kullanılacaksa, kritik SEO içeriği ile ikincil etkileşim verisini ayırmak gerekir. Ana metin, ürün veya kategori başlıkları, açıklamalar, breadcrumb, ana linkler ve metadata ilk HTML'de yer almalı; filtre sonuçları, kullanıcıya özel öneriler veya ikincil bileşenler sonradan yüklenebilir. Böyle bir ayrım hem SEO güvenliği sağlar hem de uygulamanın etkileşimli yapısını korur.
SSR nedir, nasıl çalışır ve hangi durumlarda avantaj sağlar?
SSR yani server-side rendering, her istekte sayfanın HTML'inin sunucu tarafında oluşturulup istemciye gönderilmesidir. Kullanıcı veya crawler sayfayı istediğinde sunucu bileşenleri çalıştırır, gerekli veriyi toplar ve tamamlanmış ya da büyük ölçüde tamamlanmış HTML üretir. Böylece ilk yanıt içinde daha anlamlı içerik bulunur ve sayfa konusu daha erken anlaşılır.
SEO açısından SSR'nin en büyük avantajı, crawler'ın JavaScript çalıştırmayı beklemeden temel içeriğe erişebilmesidir. Başlık, açıklama, H1, kategori metni, ürün kartları, liste bağlantıları ve yapısal bölümler ilk HTML içinde bulunduğu için keşif ve yorumlama süreci daha sağlam ilerler. Özellikle sürekli güncellenen içeriklerde, stok durumu veya sık değişen listelemelerde SSR güçlü bir çözümdür.
Bununla birlikte SSR her proje için otomatik olarak en iyi seçenek değildir. Her istekte sunucu tarafında render yapmak altyapı maliyeti, önbellekleme karmaşıklığı ve yanıt süresi açısından dikkat ister. Veri kaynakları yavaşsa TTFB yükselir ve kötü optimize edilmiş SSR, teorik avantajına rağmen pratikte zayıf performans üretebilir.
React ve Next.js ekosisteminde modern SSR, yalnızca klasik tam sayfa render mantığıyla sınırlı değildir. Akış bazlı rendering, sunucu bileşenleri, edge rendering ve kısmi veri çözümleme gibi gelişmiş yaklaşımlar sayesinde HTML daha erken gönderilebilir. Ancak temel ilke değişmez: indekslenmesi beklenen esas içeriği mümkün olduğunca erken, tercihen initial HTML içinde teslim etmek.
SSG nedir ve hangi sayfalarda SSR'den daha doğru bir tercih olabilir?
SSG yani static site generation, sayfaların HTML çıktısının derleme aşamasında önceden üretilmesidir. Kullanıcı veya crawler isteği geldiğinde sunucu anlık render yapmak yerine hazır statik dosyayı sunar. Bu yaklaşım genellikle çok hızlıdır ve özellikle içerik ağırlıklı sitelerde mükemmel performans ile güçlü indekslenebilirliği bir arada sunabilir.
SEO açısından SSG'nin temel avantajı, kararlı ve dolu bir initial HTML sağlamasıdır. Blog yazıları, rehber içerikler, hizmet sayfaları, kurumsal tanıtım sayfaları, sık değişmeyen landing page'ler ve dokümantasyon alanları için son derece uygundur. Çünkü bu sayfalar çoğunlukla kullanıcıya özel değil, herkese aynı içerik setini sunar.
Bununla birlikte SSG'nin sınırlamaları da vardır. İçerik çok sık değişiyorsa, büyük veri kümeleri varsa veya sayfa çıktısı isteğe göre farklılaşıyorsa yalnızca build time üretim yetersiz kalabilir. Bu durumda incremental static regeneration gibi ara modeller veya SSR tercih edilebilir.
SSG ile çalışan projelerde geliştiricilerin dikkat etmesi gereken konu, statik HTML'in gerçekten anlamlı olup olmadığıdır. Bazı ekipler statik kabuk üretip asıl içeriği yine istemci tarafında doldurur. Bu durumda teknik olarak SSG kullanılıyor gibi görünse de SEO avantajının önemli kısmı kaybedilir. SSG'nin gerçek gücü, asıl içeriğin önceden oluşturulmuş ve ilk yanıtta teslim edilmiş olmasından gelir.
Crawler rendering nasıl işler: tarama, işleme, render ve indeksleme zinciri
Arama motorları bir URL'yi tek adımda sihirli biçimde anlamaz. Süreç kabaca keşif, tarama, ilk HTML analizi, kaynak planlaması, render, içerik çıkarımı ve indeksleme aşamalarından oluşur. Özellikle JavaScript yoğun sayfalarda, ilk tarama ile tam render edilmiş değerlendirme aynı anda gerçekleşmeyebilir.
Google özelinde sık anlatılan model iki dalgalı indeksleme fikridir. İlk dalgada bot URL'yi alır, initial HTML'i inceler, temel sinyalleri toplar ve bağlantıları keşfeder. İkinci aşamada uygun kaynak ayrıldığında JavaScript çalıştırılır, DOM yeniden oluşturulur ve ek içerik işlenir. Her durumda zamanlama garantisi yoktur ve özellikle büyük sitelerde bu fark operasyonel olarak önemlidir.
Crawler rendering sürecinde sayfanın ihtiyaç duyduğu JavaScript dosyaları, CSS, API çağrıları ve görsel kaynaklar da dolaylı rol oynar. Robots ile engellenen kaynaklar, hatalı script yüklemeleri, çok ağır paketler veya başarısız API istekleri render sonucunu etkileyebilir. Bu yüzden yalnızca HTML'e değil, render zincirinin tamamına bakmak gerekir.
SEO uzmanları için önemli çıkarım şudur: "Google sonunda görür" varsayımı güvenli bir strateji değildir. Evet, birçok durumda Google JavaScript çalıştırabilir, ancak kritik içeriği JavaScript sonrasına bırakmak teslimat riskini artırır. En güvenli yaklaşım, indekslenmesi istenen ana içeriği ilk HTML içinde sunmak ve JavaScript'i zenginleştirme katmanı olarak kullanmaktır.
SSR, SSG, CSR ve hydration arasındaki gerçek ilişki nasıl okunmalı?
Bu kavramlar çoğu zaman birbirine karıştırılır çünkü aynı sayfa birden fazla tekniği birlikte kullanabilir. Örneğin bir Next.js sayfası SSG ile üretilmiş olabilir, ilk HTML statik gelir, ardından hydration çalışır ve bazı veriler client-side olarak güncellenir. Başka bir sayfa SSR olabilir, ama filtreleme paneli tamamen istemci tarafında çalışabilir. Yani tek bir etiketle tüm sayfa davranışını açıklamak çoğu zaman mümkün değildir.
Daha sağlıklı okuma için şu soruları sırayla sormak gerekir: İlk HTML'de ne var, etkileşim ne zaman geliyor, kritik veri ne zaman geliyor, crawler JavaScript çalıştırmadan sayfanın amacını anlayabiliyor mu, bağlantıları keşfedebiliyor mu? Eğer bu soruların ilk birkaçına olumlu yanıt verilebiliyorsa mimari genellikle SEO açısından güvenli temelde kurulmuştur.
Aşağıdaki tablo, temel farkları pratik açıdan özetler:
Rendering yaklaşımlarının teknik ve SEO karşılaştırması
Genel kullanım mantığını hızlı karşılaştırma için özetler.
| Yaklaşım | Initial HTML | Veri geliş zamanı | SEO güvenliği | Tipik kullanım |
|---|---|---|---|---|
| CSR | Zayıf veya boş olabilir | JavaScript sonrası | Düşükten orta seviyeye | Dashboard, uygulama içi alanlar |
| SSR | Güçlü ve isteğe özel | Sunucuda istek anında | Yüksek | Dinamik listeleme, güncel içerik |
| SSG | Güçlü ve önceden üretilmiş | Build sırasında | Çok yüksek | Blog, kurumsal sayfalar, rehberler |
| Hybrid | Kritik içerik HTML'de, kalan kısım sonradan | Karma | Yüksek | Modern içerik ve ticaret siteleri |
| Hydration | Render yöntemi değil, etkileşim katmanı | HTML sonrası | İçeriğin ilk HTML'de olmasına bağlı | React tabanlı etkileşimli sayfalar |
Bu tabloyu yorumlarken hydration'ın SSR veya SSG'ye rakip bir model olmadığını unutmamak gerekir. Hydration çoğunlukla SSR veya SSG ile gelen HTML'in istemci tarafında aktifleşmesini sağlar. Dolayısıyla SEO tartışmasında asıl soru, hydration var mı değil, hydration öncesinde anlamlı içerik teslim ediliyor mu sorusudur.
React ve Next.js projelerinde sık yapılan SEO hataları
En yaygın hata, geliştirici araçlarında görülen son DOM'u referans alıp sayfanın SEO açısından güvenli olduğunu varsaymaktır. Kullanıcı tarafında içerik görünmesi, initial HTML'in de aynı içeriği taşıdığı anlamına gelmez. Özellikle app router, server component, client component ve veri çekme stratejileri karışık kullanıldığında hangi parçanın ne zaman render edildiği gözden kaçabilir.
Bir diğer yaygın hata, metadata'yı istemci tarafında üretmektir. Title, description, canonical, Open Graph ve benzeri alanlar mümkün olduğunca sunucu tarafında veya build aşamasında üretilmelidir. Eğer bu veriler JavaScript sonrasında değişiyorsa bazı botlar bunları geç, eksik veya tutarsız algılayabilir.
Listeleme sayfalarında yalnızca skeleton göstermek de problem yaratabilir. Kullanıcı deneyimi için skeleton yararlı olsa da, ilk HTML tamamen placeholder içerikten oluşuyorsa crawler gerçek bağlamı alamaz. Skeleton'ın yanında gerçek başlık, açıklama, kategori metni ve bazı anlamlı içerik alanlarının bulunması daha sağlıklıdır.
Ayrıca dahili linklerin yalnızca JavaScript event'lerine bağlı oluşturulması keşfi zorlaştırabilir. Arama motorları standart anchor etiketleriyle sunulan bağlantıları çok daha güvenilir şekilde takip eder. Filtreler, sekmeler ve sonsuz kaydırma yapıları içinde indekslenmesi istenen URL'lerin açık linkler olarak sunulması önemlidir.
Teknik denetimde nelere bakılmalı: geliştirici ve SEO uzmanı için kontrol listesi
JavaScript tabanlı bir sitenin arama motorları açısından sağlıklı çalışıp çalışmadığını anlamak için tek bir araç yeterli değildir. Önce ham HTML yanıtı kontrol edilmeli, ardından tarayıcıda JavaScript kapalı senaryoda ne göründüğüne bakılmalı, sonrasında render edilmiş DOM ve ağ istekleri incelenmelidir. URL Inspection, Rich Results testleri, log analizi ve başlıca sayfalarda manuel kaynak kod incelemesi birlikte kullanılmalıdır.
Aşağıdaki kontrol listesi pratik bir çerçeve sunar:
- İlk HTML içinde title, meta description, canonical ve H1 var mı?
- Ana içerik veya en azından anlamlı metinsel özet initial HTML içinde bulunuyor mu?
- Ürün, kategori veya yazı linkleri standart anchor yapısıyla sunuluyor mu?
- İçerik yüklemek için gereken API çağrıları crawler ortamında hatasız çalışıyor mu?
- Robots, noindex, canonical veya yönlendirme zincirleri render akışını bozuyor mu?
- JavaScript paketleri aşırı ağır olduğu için render gecikmesi yaşanıyor mu?
- Sunucu ve istemci çıktısı arasında hydration mismatch oluşuyor mu?
- Filtreli veya paginated sayfalarda keşfedilebilir URL yapısı korunuyor mu?
Gelişmiş projelerde log bazlı inceleme de büyük değer taşır. Googlebot'un hangi URL'leri ne sıklıkla ziyaret ettiği, hangi kaynakları çağırdığı, 200 yerine hata alıp almadığı ve önemli sayfaların tekrar taranma aralığı, teorik mimarinin pratikte nasıl çalıştığını gösterir. Özellikle büyük sitelerde crawl budget tartışmaları gerçek log verisi olmadan eksik kalır.
Buna ek olarak içerik ekipleri ile geliştirici ekiplerinin aynı teslim modelini anlaması gerekir. SEO uzmanı "bu içerik var" dediğinde geliştirici hangi aşamada var olduğunu sormalıdır. Kullanıcıya sonradan gelen içerik ile initial HTML içinde hazır bulunan içerik arasındaki fark, teknik denetimin merkezinde yer almalıdır.
Hangi durumda hangi yaklaşım seçilmeli?
Tüm sayfalar için tek bir rendering stratejisi seçmek çoğu zaman verimsizdir. Kurumsal tanıtım sayfaları, blog içerikleri, rehberler ve lokasyon sayfaları için SSG veya güçlü önbellekli SSR genellikle en mantıklı çözümdür. Sürekli güncellenen kategori, ürün, stok ve fiyat sayfalarında SSR veya hibrit modeller daha uygun olabilir.
Buna karşılık üyelik gerektiren paneller, kullanıcıya özel rapor ekranları, sipariş geçmişi, canlı mesajlaşma veya uygulama içi araçlar için client-side rendering gayet doğaldır. Çünkü bu sayfalar çoğunlukla indekslenmek için değil, işlevsellik için vardır. Sorun, indekslenmesi gereken pazarlama veya içerik sayfalarının da yanlışlıkla aynı mimariyle üretilmesidir.
Pratik ve sürdürülebilir yaklaşım, sayfa tipine göre karar vermektir. SEO kritik sayfalarda ilk HTML'i güçlendirin, etkileşimli ama ikincil alanları hydration sonrasına bırakın, kullanıcıya özel veriyi istemci tarafında yönetin. Böylece hem modern arayüzlerden vazgeçmeden hem de arama motorları için güçlü teslimat modeli kurarak dengeli bir yapı elde edebilirsiniz.
Pratikweb gibi hazır web sitesi ve geliştirilebilir platform yaklaşımı sunan yapılarda da bu denge önemlidir. Hazır altyapı kullanılsa bile her sayfa türünün aynı şekilde render edilmesi gerekmez. Hizmet sayfaları, blog içerikleri, kategori yapıları ve platform modülleri için doğru rendering kombinasyonu seçildiğinde hem performans hem SEO hem de yönetim kolaylığı birlikte sağlanabilir.
Sonuç: Arama motorlarına görünürlük, doğru teslim mimarisiyle kazanılır
JavaScript kullanan bir sitenin SEO başarısı, yalnızca framework seçimine değil, içeriğin arama motoruna hangi aşamada teslim edildiğine bağlıdır. Initial HTML ne kadar anlamlıysa, kritik metadata ne kadar erken üretiliyorsa ve crawler JavaScript'e bağımlı kalmadan sayfanın amacını anlayabiliyorsa teknik risk o kadar azalır. Hydration ve client-side data loading güçlü araçlardır, ancak ana içeriğin yerini almamalıdır.
Yeni bir proje kuruyor veya mevcut React, Next.js tabanlı yapıyı iyileştiriyorsanız önce sayfa tiplerini sınıflandırın, ardından her tip için SSR, SSG veya hibrit yaklaşımı ayrı belirleyin. Sonrasında ham HTML, render sonucu ve log verileri üzerinden doğrulama yapın. Doğru rendering stratejisi, yalnızca indekslenmeyi kolaylaştırmaz; aynı zamanda daha hızlı, daha anlaşılır ve daha sürdürülebilir bir web mimarisi oluşturur.