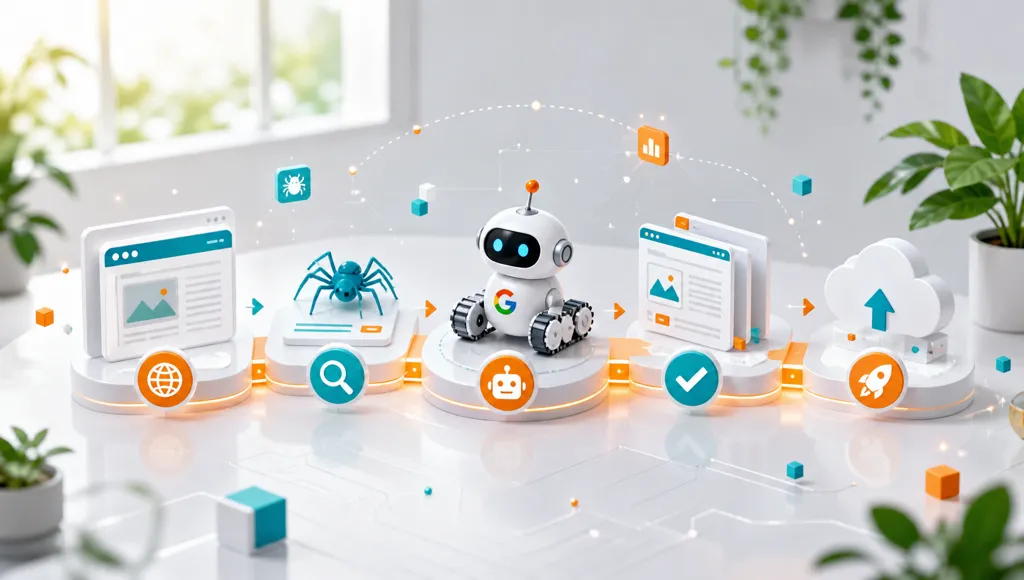
Bu kapsamlı rehberde arama motorlarının web sayfalarını keşfetme, link discovery, sitemap kullanımı, Googlebot’un tarama mantığı, rendering süreci, indexing kararları ve serving aşaması teknik açıdan detaylı biçimde açıklanır. İçerik özellikle geliştiriciler, SEO uzmanları ve teknik site yöneticileri için hazırlanmıştır.
Discovery, Googlebot, Crawling, Rendering, Indexing ve Serving Süreçleri Nasıl Çalışır?
Arama motoru optimizasyonu çoğu zaman içerik, başlık etiketi ve backlink düzeyinde konuşulsa da işin temeli çok daha altyapısaldır. Bir sayfanın Google sonuçlarında görünmesi için önce keşfedilmesi, ardından taranması, gerektiğinde işlenmesi, uygun görülürse dizine eklenmesi ve son olarak doğru sorgularda servis edilmesi gerekir. Bu zincirin herhangi bir halkasında oluşan teknik sorun, en iyi içeriğin bile görünmez kalmasına neden olabilir.
Özellikle geliştiriciler, teknik SEO uzmanları ve site yöneticileri için discovery, crawling, rendering, indexing ve serving süreçlerini ayrı ayrı anlamak kritik önemdedir. Çünkü robots.txt, HTTP durum kodları, canonical sinyalleri, JavaScript mimarisi, iç link yapısı ve XML sitemap kullanımı bu aşamaların her birini doğrudan etkiler. Bu yazıda süreci teknik ama anlaşılır bir çerçevede ele alacağız.
Discovery Nedir ve Arama Motorları Sayfaları İlk Olarak Nasıl Bulur?
Discovery, arama motorlarının bir URL’den ilk kez haberdar olması sürecidir. Google bir sayfayı ancak varlığını öğrendikten sonra tarama kuyruğuna alabilir. Bu nedenle discovery, tüm organik görünürlüğün başlangıç noktasıdır ve teknik SEO’da çoğu sorunun kaynağı da burada bulunur.
Bir URL’nin keşfedilmesinin en yaygın yolu bağlantılardır. Googlebot, daha önce bildiği bir sayfayı tararken o sayfadaki dahili ve harici bağlantıları analiz eder, ardından bu bağlantılardan yeni URL adayları çıkarır. Bu yüzden crawl edilebilir, HTML içinde yer alan, erişilebilir ve anlamlı iç linkler discovery açısından son derece değerlidir.
Discovery yalnızca bağlantılarla sınırlı değildir. XML sitemap dosyaları, feed yapıları, canonical işaretleri, yönlendirmeler, dahili site haritaları ve bazı durumlarda harici referanslar da keşif sürecine katkı sağlar. Ancak burada kritik nokta şudur: discovery, indeksleme garantisi vermez; sadece URL’nin değerlendirmeye alınmasını sağlar.
Arama motorları aynı zamanda daha önce bilinen URL kalıplarından da yeni kaynaklar türetebilir. Örneğin kategori, etiket, sayfalama veya filtreleme yapıları belirli bir örüntü taşıyorsa Google benzer URL’leri tanımlayabilir. Fakat bu durum, kontrolsüz parametreli URL üretiminin crawl bütçesini boşa harcamasına da yol açabilir.
Link Discovery Mantığı ve Dahili Link Mimarisi Neden Bu Kadar Önemlidir?
Link discovery, yeni URL’lerin bağlantılar üzerinden keşfedilmesi anlamına gelir. Googlebot için bağlantılar sadece gezinme araçları değil, aynı zamanda bir sitenin bilgi mimarisini ve önem dağılımını anlamanın temel yoludur. Bir sayfaya hiç link verilmiyorsa veya sadece kullanıcı etkileşimi sonrası oluşan JavaScript olaylarıyla ulaşılabiliyorsa, keşfedilme olasılığı ciddi biçimde düşebilir.
Dahili link mimarisi, hangi sayfaların daha hızlı ve daha sık keşfedileceğini belirler. Ana sayfa, kategori sayfaları, içerik hub’ları ve breadcrumb yapıları üzerinden güçlü biçimde bağlanan URL’ler genellikle daha erken fark edilir. Buna karşılık sadece site içi arama sonucu oluşan, filtreyle üretilen veya derin gezinme katmanlarında kalan sayfalar discovery sürecinde zayıf kalabilir.
Google, standart HTML anchor etiketleri içindeki href değerlerini en güvenilir keşif sinyallerinden biri olarak kullanır. Bu nedenle
buttonAnchor text de dolaylı olarak önemlidir. Anchor text, sadece bağlantı verilen URL’nin konusu hakkında bağlamsal sinyal taşımaz, aynı zamanda sitenin içerik kümelerini anlamaya yardımcı olur. Tutarlı ve açıklayıcı iç bağlantı metinleri, discovery ile birlikte tematik ilişki kurulumunu da güçlendirir.
Aşağıdaki tablo, link discovery açısından sık karşılaşılan yapıların etkisini özetler:
| Yapı | Discovery Etkisi | Not |
|---|---|---|
HTML a href | Yüksek | En güvenilir yöntemlerden biridir |
| JavaScript onclick ile geçiş | Orta/Düşük | Render bağımlılığı yaratabilir |
| Form submit ile URL erişimi | Düşük | Bot için net bağlantı sinyali olmayabilir |
| XML sitemap içindeki URL | Destekleyici | Keşfi hızlandırabilir ama linkin yerini tutmaz |
| Sadece noindex sayfadan link | Değişken | Google yine de linkleri takip edebilir |
| Robots ile engellenen sayfadaki link | Düşük/Belirsiz | İçerik görülemediği için keşif sınırlanabilir |
XML Sitemap Nedir, Link Discovery ile İlişkisi Nasıldır?
XML sitemap, arama motorlarına sitenizde önemli gördüğünüz URL’leri listeleyen makine okunabilir bir dosyadır. Sitemap, özellikle yeni sayfalar, derin mimaride kalan içerikler, büyük siteler ve zayıf iç link yapısına sahip projelerde discovery sürecine yardımcı olur. Ancak sitemap, bir tarama veya dizine ekleme emri değildir; daha çok güçlü bir öneri niteliği taşır.
Link discovery ile sitemap arasındaki ilişki tamamlayıcıdır, ikame edici değildir. Sağlam iç link yapısı olmayan bir sitede sadece sitemap kullanmak kısa vadede bazı URL’lerin fark edilmesini sağlayabilir, fakat bu yapı sürdürülebilir değildir. Google, bir URL’yi sitemap’ta görse bile o sayfanın sitenin geri kalanıyla ilişkisini bağlantılar üzerinden daha iyi değerlendirir.
İyi bir XML sitemap, yalnızca kanonik, indexlenebilir, 200 durum kodu dönen ve gerçekten değer taşıyan URL’leri içermelidir. 3xx, 4xx, 5xx, noindex, robots ile engelli veya canonical ile başka bir URL’ye işaret eden sayfaları sitemap’a eklemek kalite sinyalini zayıflatır. Bu durum, özellikle büyük ölçekli sitelerde arama motoruna gereksiz yük bindirir.
Sitemap dosyalarındaki
lastmodSitemap kullanırken şu teknik ilkelere dikkat etmek gerekir:
- Sadece indexlenmesini istediğiniz URL’leri ekleyin.
- HTTP ile HTTPS, www ile non-www, slash ve parametre varyasyonlarını normalize edin.
- Büyük sitelerde içerik tipine göre sitemap index yapısı kurun.
- Haber, ürün, kategori ve içerik sitemap’larını ayrı tutmak yönetimi kolaylaştırır.
- Search Console üzerinden sitemap gönderimini takip edin.
- Sitemap’ı robots.txt içinde belirtin.
Googlebot ve Crawling Süreci Nasıl Çalışır?
Crawling, Googlebot’un bilinen URL’leri ziyaret ederek içerik ve sinyal toplama sürecidir. Discovery aşamasında fark edilen her URL hemen taranmaz; öncelik, kalite, popülerlik, sunucu kapasitesi, güncellenme sıklığı ve crawl budget gibi faktörler devreye girer. Bu nedenle bir URL’nin keşfedilmiş olması ile taranmış olması arasında zaman farkı olabilir.
Googlebot bir URL’ye istek gönderdiğinde önce teknik erişilebilirliği değerlendirir. DNS çözümleme, TCP/TLS bağlantısı, HTTP yanıt kodu, yönlendirme zinciri, yanıt süresi ve içerik tipi bu aşamada önemlidir. Sunucu sürekli hata dönüyorsa veya aşırı yavaşsa, tarama sıklığı düşebilir ve bazı URL’ler daha seyrek ziyaret edilebilir.
Crawling yalnızca HTML belgeyi çekmekten ibaret değildir. Google, gerekli gördüğünde CSS, JavaScript, görsel ve bazı ek kaynakları da isteyebilir. Çünkü özellikle modern sitelerde görünür içeriğin ve linklerin önemli kısmı bu kaynaklara bağlıdır. Robots.txt ile kritik CSS veya JS dosyalarını engellemek, sayfanın doğru anlaşılmasını zorlaştırabilir.
Burada crawl budget kavramı devreye girer. Crawl budget, basitçe Google’ın belirli bir siteye ayırdığı tarama kaynaklarının toplam etkisi olarak düşünülebilir. Çok büyük sitelerde düşük değerli URL üretimi, sonsuz filtre kombinasyonları, parametre kaosu ve gereksiz yönlendirmeler bu bütçeyi tüketerek önemli sayfaların daha geç taranmasına yol açabilir.
Teknik olarak crawling’i etkileyen temel unsurlar şunlardır:
- HTTP durum kodları
- robots.txt kuralları
- dahili link derinliği
- sunucu yanıt süresi
- yönlendirme sayısı ve kalitesi
- duplicate URL üretimi
- canonical sinyaller
- parametreli yapıların kontrolü
Robots.txt, HTTP Durum Kodları ve Canonical Sinyalleri Crawling’i Nasıl Etkiler?
Robots.txt, arama motoru botlarına hangi URL desenlerine erişmemeleri gerektiğini söyleyen bir yönerge dosyasıdır. Ancak bu dosya bir URL’yi web’den yok etmez, yalnızca tarama davranışını sınırlar. Eğer bir URL’ye dışarıdan veya içeriden link veriliyorsa, Google o URL’yi içeriğini görmeden de keşfedebilir ve bazı durumlarda sınırlı bilgiyle değerlendirebilir.
Bu nedenle robots.txt ile engellenen ama indekslenmesi istenmeyen URL’lerde dikkatli olunmalıdır. Çünkü Google içeriği göremediği için sayfadaki noindex etiketini de okuyamaz. Pratikte, bir URL’nin taranabilir ama noindex olması ile robots üzerinden tamamen engellenmesi farklı sonuçlar üretir.
HTTP durum kodları crawling’in yönünü belirler.
200 OK3013084044105xxCanonical etiketi ise özellikle duplicate veya benzer içerikli URL kümelerinde tercih edilen ana sürümü belirtmek için kullanılır. Bu etiket taramayı durdurmaz, ancak Google’a hangi URL’nin esas değerlendirilmesi gerektiği konusunda sinyal verir. Canonical ile robots, noindex, internal links ve sitemap sinyallerinin çelişmesi durumunda Google kendi kararını verebilir.
Aşağıdaki özet, bu sinyallerin görevlerini netleştirir:
| Mekanizma | Temel İşlev | Sınırlama |
|---|---|---|
| robots.txt | Taramayı kısıtlar | İçerik okunamaz, noindex görülemez |
| meta robots noindex | İndekslemeyi engeller | Sayfanın taranabilir olması gerekir |
| canonical | Tercih edilen URL’yi önerir | Mutlak komut değildir |
| 301 yönlendirme | Kalıcı taşınmayı bildirir | Zincirler verim düşürür |
| 404/410 | URL’nin kaldırıldığını belirtir | Çok sayıda yanlış üretim kaliteyi etkileyebilir |
Rendering Nedir ve JavaScript Sitelerde Neden Kritik Bir Aşamadır?
Rendering, taranan ham içeriğin, özellikle JavaScript çalıştırılarak işlenmesi sürecidir. Klasik HTML sitelerde Google çoğu zaman ana içeriği ilk istekte alabilir. Ancak modern framework’lerle oluşturulmuş uygulamalarda içerik, linkler, meta veriler veya kritik sayfa parçaları istemci tarafında üretildiği için ek bir işleme katmanı gerekir.
Google genel olarak iki aşamalı bir model izler. İlk aşamada ham HTML alınır ve hızlı değerlendirme yapılır. İkinci aşamada gerekliyse sayfa render kuyruğuna girer, JavaScript çalıştırılır ve nihai DOM üzerinden ek içerik, link ve sinyaller çıkarılır. Bu ikinci aşama her zaman anlık değildir, dolayısıyla tamamen JS ile üretilen içeriklerde keşif ve indeksleme gecikebilir.
Teknik SEO açısından temel soru şudur: Sayfanın kritik içeriği ve kritik bağlantıları ilk HTML’de var mı? Eğer başlık, metin, ürün bilgisi, pagination linkleri veya dahili bağlantılar sadece render sonrası oluşuyorsa, Google bunları daha geç görebilir veya bazı durumlarda eksik yorumlayabilir. Bu nedenle SSR, SSG, ISR veya hibrit render stratejileri çoğu projede SEO açısından avantaj sağlar.
Rendering aşamasında karşılaşılan yaygın problemler arasında engellenen JS/CSS dosyaları, yavaş API yanıtları, hydration hataları, kullanıcı etkileşimi gerektiren içerik yüklemeleri ve fragment tabanlı URL yapıları bulunur. Ayrıca lazy load mekanizmaları doğru uygulanmadığında görseller veya içerik blokları bot tarafından hiç görülmeyebilir. Özellikle sonsuz kaydırma kullanılan yapılarda crawl edilebilir paginasyon alternatifi sunmak önemlidir.
JavaScript SEO için en iyi uygulamalardan bazıları şunlardır:
- Kritik içeriği mümkünse sunucu tarafında üretin.
- Dahili linkleri gerçek elemanlarıyla verin.
a href - Meta title, description ve canonical gibi sinyalleri istemci tarafına bırakmayın.
- API hatalarında boş sayfa üretmeyin.
- Render sonrası değil, mümkün olduğunca ilk HTML’de anlamlı içerik sunun.
- Faceted navigation yapılarında indekslenebilir URL kontrolünü planlayın.
Indexing Nedir ve Google Bir Sayfayı Neye Göre Dizine Ekler?
Indexing, taranan ve gerektiğinde render edilen içeriğin Google’ın arama dizininde değerlendirmeye alınması sürecidir. Burada önemli nokta, her taranan sayfanın dizine eklenmediğidir. Google, kalite, benzersizlik, fayda, teknik tutarlılık ve kanonikleşme sinyallerine göre bir URL’yi dizine alabilir, başka bir URL altında birleştirebilir veya tamamen dışarıda bırakabilir.
Bir sayfanın indekslenebilir olması için erişilebilir, anlamlı içerik taşıyan ve çelişkili sinyaller üretmeyen bir yapıda olması gerekir. Örneğin 200 dönen ama ince içerikli, duplicate, yumuşak 404 davranışı gösteren veya canonical ile başka bir URL’ye işaret eden sayfalar indekslenmeyebilir. Benzer şekilde noindex etiketi, Google’a açıkça bu URL’nin dizine alınmaması gerektiğini söyler.
Google indexing kararını tek bir etikete göre vermez. İçerik kalitesi, iç linkler, harici otorite sinyalleri, kullanıcı niyetiyle eşleşme, canonical cluster yapısı ve site genel kalite algısı birlikte çalışır. Bu nedenle sadece teknik olarak açık olmak yetmez; sayfanın gerçekten indekslenmeye değer görülmesi gerekir.
Özellikle büyük sitelerde duplicate cluster yönetimi kritik hale gelir. Filtre URL’leri, sıralama parametreleri, izleme parametreleri, slash varyasyonları, dil kopyaları ve cihaz bazlı URL’ler düzgün normalize edilmezse Google aynı içeriğin farklı sürümleri arasında seçim yapmak zorunda kalır. Bu da yanlış canonical seçimlerine, crawl israfına ve görünürlük kaybına neden olabilir.
Indexing sorunlarını teşhis ederken şu başlıklara bakılmalıdır:
- Sayfa gerçekten 200 dönüyor mu?
- meta robots veya x-robots-tag ile noindex var mı?
- canonical başka URL’ye mi işaret ediyor?
- İçerik benzersiz ve yeterli mi?
- Sayfaya güçlü dahili link geliyor mu?
- Robots veya güvenlik duvarı taramayı kısmen engelliyor mu?
- Sayfa yalnızca render sonrası mı oluşuyor?
- Search Console hangi hariç tutma gerekçesini gösteriyor?
Serving Aşaması Nedir ve Arama Sonuçlarında Gösterim Nasıl Belirlenir?
Serving, Google’ın dizinindeki belgeler arasından belirli bir sorgu için uygun sonuçları seçip sıralayarak kullanıcıya sunması aşamasıdır. Bu safha, discovery ve indexing’den farklı olarak gerçek zamanlı sorgu değerlendirmesiyle ilgilidir. Bir sayfanın dizinde olması, her sorguda veya hedeflediğiniz anahtar kelimede gösterileceği anlamına gelmez.
Serving aşamasında Google, sorgu niyetini, içerik alaka düzeyini, kalite sinyallerini, otoriteyi, tazeliği, coğrafi bağlamı, cihaz uyumluluğunu ve sayfa deneyimi gibi birçok faktörü birlikte değerlendirir. Ayrıca aynı sitenin benzer sayfaları arasında hangi URL’nin en iyi cevap olduğunu da bu aşamada seçebilir. Yani yanlış URL’nin sıralanması çoğu zaman sadece içerik değil, canonical ve iç link mimarisi problemine de işaret edebilir.
Snippet üretimi de serving sürecinin bir parçasıdır. Google çoğu zaman title ve meta description etiketlerini birebir kullanmaz; sorguya göre alternatif başlık veya açıklama oluşturabilir. Başlıkların belirsiz, aşırı tekrar içeren veya sayfa içeriğiyle uyumsuz olması durumunda yeniden yazım ihtimali artar.
Serving aşaması teknik açıdan özellikle şu noktalarla ilişkilidir: doğru kanonik URL seçimi, yapılandırılmış ve tutarlı başlık sinyalleri, sorgu niyetine uygun sayfa türü seçimi, hreflang yapılandırması ve içerik kümeleri arasında net görev dağılımı. Başka bir deyişle indekslenmiş olmak başlangıçtır, görünürlük ise sorgu bazlı uygunlukla kazanılır.
Tüm Süreci Uçtan Uca Düşünmek İçin Teknik SEO Kontrol Listesi
Discovery, crawling, rendering, indexing ve serving birbirinden bağımsız değil, ardışık ve etkileşimli aşamalardır. Bir geliştirici sayfanın 200 dönmesine odaklanırken, SEO uzmanı canonical çelişkisini, sistem yöneticisi ise sunucu gecikmesini gözden kaçırabilir. Oysa organik performans, bu parçaların birlikte doğru çalışmasına bağlıdır.
Teknik ekipler için en verimli yaklaşım, URL yaşam döngüsünü uçtan uca izlemektir. Yeni bir sayfa üretildiğinde şu sorular peş peşe sorulmalıdır: Bu URL nasıl keşfedilecek, hangi linklerden beslenecek, sitemap’a girecek mi, Googlebot erişebilecek mi, içerik ilk HTML’de mevcut mu, canonical ne olacak, noindex var mı, hangi sorgu niyetine hizmet edecek? Bu bakış açısı hataları çok erken aşamada yakalamayı sağlar.
Aşağıdaki pratik kontrol listesi bu süreci operasyonel hale getirir:
Discovery kontrolü
- Yeni URL’ler ana mimariye bağlanıyor mu?
- Sayfa orphan durumda mı?
- XML sitemap içinde yer alıyor mu?
- Linkler gerçek HTML bağlantısı mı?
Crawling kontrolü
- Robots.txt yanlış engel yaratıyor mu?
- Sunucu 5xx veya timeout üretiyor mu?
- Gereksiz parametreli URL’ler oluşuyor mu?
- Redirect zincirleri var mı?
Rendering kontrolü
- Ana içerik ilk HTML’de mevcut mu?
- JS çalışmazsa içerik boş mu kalıyor?
- CSS/JS kaynakları botlara açık mı?
- Lazy load ve infinite scroll doğru uygulanmış mı?
Indexing kontrolü
- noindex, canonical ve sitemap sinyalleri tutarlı mı?
- Sayfa duplicate kümeye mi düşüyor?
- İnce veya değersiz içerik riski var mı?
- Search Console’da hariç tutma nedeni ne görünüyor?
Serving kontrolü
- Doğru URL doğru sorgu için optimize edilmiş mi?
- Başlık ve açıklama sorgu niyetiyle uyumlu mu?
- Dahili anchor text yapısı doğru sayfayı öne çıkarıyor mu?
- Benzer sayfalar birbirini kanibalize ediyor mu?
Pratikweb Gibi Yönetilen Web Altyapılarında Bu Süreçler Neden Daha Planlı Ele Alınmalıdır?
Hazır web sitesi, yönetilen platform veya servis tabanlı web altyapılarında teknik SEO süreçleri tekil sayfa düzenlemesinden daha geniş bir çerçevede değerlendirilmelidir. Çünkü URL üretimi, sayfa şablonları, meta alanları, yönlendirme mantığı, sitemap üretimi ve dahili link blokları çoğu zaman sistematik olarak çalışır. Bu da küçük bir teknik kararın yüzlerce veya binlerce sayfayı aynı anda etkilemesi anlamına gelir.
Pratikweb gibi hazır web sitesi ve geliştirilebilir platform çözümleri sunan yapılarda, özellikle sitemap kalitesi, canonical standardizasyonu, admin panelinden üretilen sayfaların crawl edilebilirliği ve modüler servislerin SEO’ya etkisi dikkatle tasarlanmalıdır. Teknik altyapı ebazaars.net gibi servis tabanlı bir yapı üzerinde çalıştığında, auth, page, pricing veya benzeri servislerin URL davranışı birlikte düşünülmelidir. Bu yaklaşım, sadece tek sayfa bazında değil, ürünün tamamında daha tutarlı bir discovery ve indexing performansı sağlar.
Yönetilen sistemlerin avantajı, iyi tasarlanmışsa SEO standartlarının merkezi olarak uygulanabilmesidir. Örneğin tüm sayfalarda doğru meta yapısı, otomatik XML sitemap üretimi, temiz URL standardı, yönlendirme kontrolleri ve mobil uyumlu render yapısı platform seviyesinde çözülebilir. Bu da teknik bilgi seviyesi sınırlı kullanıcıların bile daha sağlıklı indekslenebilen sitelere sahip olmasını sağlar.
Eğer hazır site veya platform çözümü sunuyorsanız, SEO başarısını yalnızca içerik editörüne bırakamazsınız. Altyapı düzeyinde crawl, render ve indexing dostu kararlar almak gerekir. Çünkü arama motoru görünürlüğü çoğu zaman içerik kalitesi kadar sistem mimarisinin de sonucudur.
Sonuç: Arama Motorlarında Görünürlük, Doğru İçerikten Önce Doğru İşlenebilirlik Gerektirir
Bir sayfanın Google’da görünmesi, sadece yayınlanmış olmasına bağlı değildir. Önce keşfedilmeli, sonra verimli biçimde taranmalı, doğru şekilde render edilmeli, uygun bulunursa dizine eklenmeli ve en sonunda ilgili sorguda servis edilmelidir. Teknik SEO’nun asıl değeri, bu zincirin tamamını kontrol edilebilir hale getirmesidir.
Eğer sitenizde sayfalar geç keşfediliyor, taranmasına rağmen indekslenmiyor veya yanlış URL’ler sıralanıyorsa sorunu tek bir başlıkta aramayın. Discovery’den serving’e kadar tüm yaşam döngüsünü inceleyin. Özellikle büyüyen web projelerinde, altyapı kararlarını erken aşamada doğru vermek organik görünürlüğün en güçlü kaldıraçlarından biridir.
Web Altyapınız Arama Motorlarına Gerçekten Hazır mı?
Hazır web sitesi, kurumsal site veya geliştirilebilir platform yapınızda discovery, crawling, rendering ve indexing süreçlerini daha sağlam kurgulamak istiyorsanız teknik altyapıyı bütünsel değerlendirmek gerekir.